LLM 发展迅猛,写代码的和做文书的体会应当十分明显。但 LLM 的业务似乎与其火热的现状又差了点距离。各家 LLM 厂商希望他们自己能够卖出更多的 token,一直在尝试寻找更产品化的方向。也许从 coding agent 开始,到 OpenClaw 爆发,好像吸金黑洞里才终于发现了一丝变现的曙光,Harness 一词也随之逐渐被熟知。
所谓 Harness#
Harness 是一个很模糊的词,有很多侧重于不同方面的定义。
- harness 是一个产品,将 LLM 与一系列工具和 prompt 等打包,作为一套开箱即用的完整能力供给用户。
- harness 是 AI 的底层系统,用于给 AI 提供一系列类似于工具、记忆等能力,赋予 AI 完成任务的能力。
- harness 是对 AI 能力的增强,它将一系列工具组合起来,支持 AI 原本存在缺陷的方面,使得整套系统相比 vanilla LLM 更加智能和有用。
虽然重心不太一样,当词藻回归到 Harness 的设计时,当前的节点下,大家又都保持了相似的实践:工具、记忆、todo 编排、权限管理、IM 聊天界面。
- 工具:是任何 harness 都一定会有的东西,提供给 AI 调用的能力。相比前几年前只能输出文本的 LLM,现在各厂的 LLM 都学会了输出特定格式的 function call(XML、json 等),能经引擎解析成对应的工具调用。虽然从本质上依然是文本,只要外部的系统将 function call 解析并执行,那么 AI 就有了调用工具的能力。
- 记忆:用于保存 AI 与用户交互的历史信息。LLM 受限于输入输出的总长度限制,无法记住太久远的信息。harness 将历史信息记录在硬盘、数据库等持久化存储中,使得 AI 即使丢掉了上下文,也能够在后续的交互中持续引用这些信息,从而达到了类似于长期记忆的效果。
- todo 编排:将复杂的任务分解为可执行的步骤。该模块的必要性依然来自于 LLM 的输入输出限制。有点像人写下 todo list,编排帮助 AI 在复杂任务里流转上下文。
- 权限管理:控制 AI 的访问权限。只给 AI 提供它完成任务需要的权限,避免滥用风险。
- IM 聊天界面:提供用户与 AI 交互的界面。Claude Code 的命令行,OpenCode 的 TUI,Codex 的 GUI,以及 claw 系 harness 选择直接和 IM 聊天界面集成。各有各的想法。
一眼望去真挺像个操作系统。将之与计算机中的各个组件相互类比,也算有些道理。
Harness 的核心是确定性的权衡#
以我个人的浅薄看法,Harness 的核心在它的字面意义。
我们可以设想这样的情况。如果 AI 智力强如你我,那上节中所有提到的设计几乎都可以归约为 write/read。虽然权限可能例外,但工具、记忆、todo,都只是在提供一种确定性的结构化交互:我们希望 AI 按照工具 doc 去执行任务,于是设计了 json schema;希望将记忆划分为瞬时、短期、长期,于是搞了各种存储结构;todo 也是如此。如果 AI 强到能够自主完成这些结构化操作,那完全可以赋予它一支更加自由的笔和纸,让它自行完成一切。
那为什么现实却是人们非要搞一堆花里胡哨的 harness 呢?
原因非常简单:AI 做不到。甚至某种意义上永远做不到。
- 人们不喜欢 AI 的不确定性,AI 是人预期的破坏者。
- 当你不向 AI 说明某个知识时,AI 连这个知识的存在都不知道。
我认为克服这部分问题的那种东西就是 Harness。
更具体的说。一段明确的脚本总按其内部编写的命令完成任务。这是很好的契约。但 LLM?既然 LLM 的优势来自于「自主」,原本的契约好像变成了 AI 按照人的预期范围内完成任务。
Harness 就是用来调控「范围」的存在。它曾经是 DSpy(单元函数),后来是 n8n(workflow),再后来是 claude code(ReAct+workflow),再后来是 claw 系(ReAct+SKILL)。Harness 始终存在,它不断适配 LLM 逐步提升的能力,形态不断发生着改变,变得更松弛,不过目的始终没变。
SKILL.md 有意义 但 SKILL Market 不好说#
SKILL.md 的出现是人们向 AI 进一步放权的体现,可以视作一种软 workflow。
从这种看法出发,我认为 SKILL.md 并不是如 MCP 昙花一现的产物(虽然 claw 多少失去热度了)。SKILL 是 LLM 的新人 101,是人管控预期和 AI 行动范围的契约。
但我不确定 SKILL market 是不是个好想法。
假设有一个 SKILL 值得登上市场而被广大群众使用,那么它就是广泛认可的知识。可是 LLM pretrain 时最不缺的就是这个。既然是极有可能存在于 pretrain data 里的东西,又为何需要再大费周折写成冗长的 SKILL 呢?一段 AGENT.md 中的 prompt 足矣了。反之,如果是一个不惯用的 SKILL,又为何能在市场中受到广大群众的追捧?
Market 里存在热度超高的公共 SKILL,真是个奇怪的事。模型厂该反思下为何没有及时把这种大自然的馈赠加到 dataset 里去。
LLM 与 User 间永存的 GAP#
一个 general LLM 作为集人类知识的相对中立者,能满足广泛存在的需求,就也必然无法满足某个特定用户的「癖好」。
最新 LLM 训练往往分多个过程,每一个环节为模型引入不同的能力维度,去除了有害输出的同时也扼杀了模型的潜力。平衡二者是极为系统的工程,牵一发而动全身,每引入一个新的 perference,几乎都会对奖励体系产生影响,损害模型能力。
最近一个搞笑例子是 Anthropic,他们发现从数据中删除商科内容居然能提升模型的全局表现:
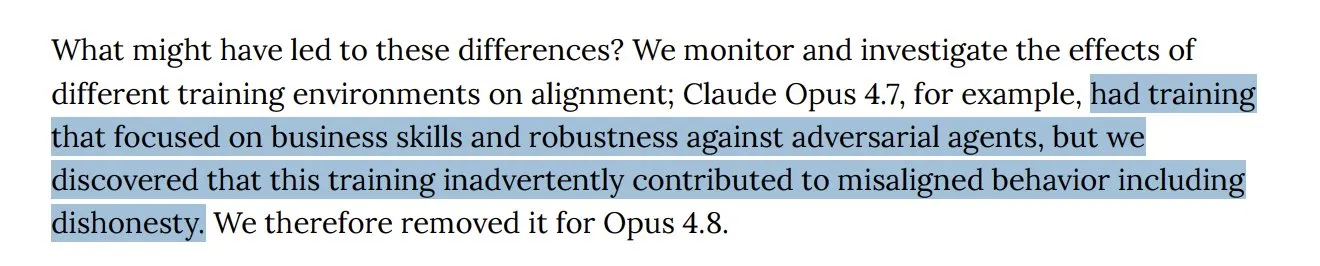
仅仅是想提升一点商业技能而已,结果却会让模型「喜欢撒谎」。
在商科和诚实之间,Anthropic 选择了后者,来服务更多的人。
总之,无论从技术和商业讲,模型都很难为一人定制,GAP 存在于模型和每个人之间。那面对这样一个聪明的模型,为了不成为小部分,我们要么适应模型,要么就教育模型变成自己的样子。
这大概是 harness 该做好的事情了,决定好什么该控制,什么该放手,逐渐把 llm 调教成用户的模样。
也是感谢 LLM 愈发强大的泛化能力,至少现在大家只要编段话就能拿到 80% 的效果。Prompt 也好,SKILL 也好,都会成为使用模型的必学课,用于填充最后那段越来越小但始终存在的 gap。但补齐这个 gap 的填料,可能也就是你剩下的一切。
希望大家珍惜自己的 Context。